Oracle e OpenAI cancellano l'espansione di Abilene ma il piano da 4,5 GW resta in piedi
Lo stop ai 600 MW aggiuntivi del campus texano non segnala un calo della domanda di intelligenza artificiale, ma rivela un problema strutturale: GPU, energia e infrastrutture fisiche viaggiano su tempi completamente diversi.
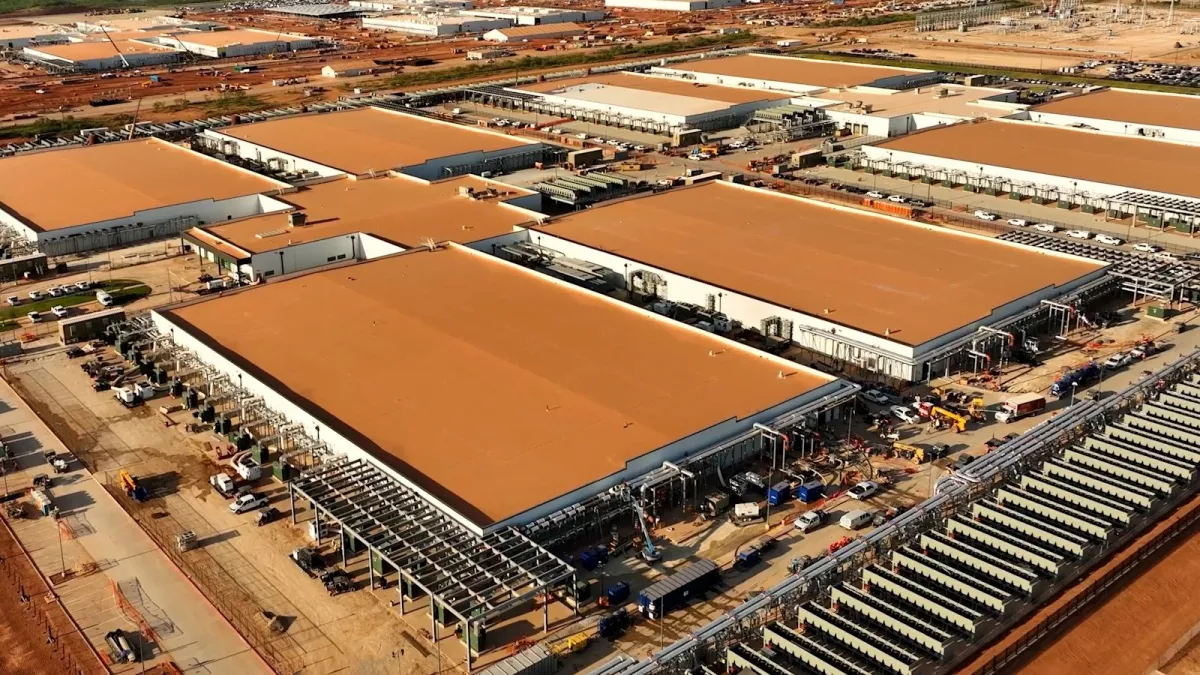
Nel mondo dei grandi data center per l'intelligenza artificiale, annunciare un campus da un gigawatt è diventato quasi ordinario. Quello che è ancora raro è riuscire a costruirlo nei tempi giusti, con la giusta elettricità disponibile e la giusta generazione di chip da installare. La vicenda di Abilene, in Texas, è esattamente questo: uno stress test pubblico su cosa succede quando le tre variabili — hardware, energia e infrastruttura fisica — smettono di essere sincronizzate.
Cosa si ferma ad Abilene
Il campus Stargate di Abilene non chiude. Rimane uno dei perni principali del progetto: circa mille acri di terreno, otto edifici previsti, due già operativi e gli altri in fase di completamento, per una capacità complessiva dichiarata intorno a 1,2 gigawatt. Quello che si interrompe è il piano di portare quel campus verso i 2 GW con un blocco aggiuntivo da 600 MW, un'espansione che avrebbe richiesto nuovi finanziamenti, nuova ingegneria e soprattutto la certezza di avere energia elettrica disponibile in tempo e un sistema di raffreddamento all'altezza.
Il raffreddamento, in questo contesto, non è un dettaglio secondario. I rack di ultima generazione — come quelli basati sulle GPU Nvidia Blackwell GB200 — consumano decine di kilowatt ciascuno e richiedono sistemi di liquid cooling, cioè raffreddamento a liquido, molto più complessi dei tradizionali impianti ad aria. Le ricostruzioni più recenti citano un episodio di fermo multi-giorno legato a condizioni meteo invernali che avrebbe impattato componenti del liquid cooling, facendo emergere tensioni tra OpenAI e Crusoe, il partner infrastrutturale del sito. Non è un incidente definitivo, ma è un segnale: l'affidabilità di questi impianti dipende da pompe, tubazioni, scambiatori di calore, ridondanze e procedure operative sul campo, non solo dai chip e dal software.
Il problema non sono le GPU, è il momento giusto
La lettura più superficiale della vicenda è «OpenAI e Oracle litigano e il progetto si ferma». Quella più accurata è un'altra: costruire un data center AI oggi significa scommettere su quale generazione di chip sarà disponibile quando l'impianto sarà pronto. E in questo momento quella scommessa è particolarmente rischiosa.
Nvidia ha lanciato Blackwell come piattaforma di riferimento per i rack ad altissima densità di calcolo, ma ha già fissato le aspettative del mercato su Vera Rubin, la generazione successiva, prevista nella seconda metà del 2026, con promesse di prestazioni fino a cinque volte superiori e costi per operazione dieci volte inferiori rispetto a Blackwell. In questo contesto, avviare oggi un'espansione che sarà pronta proprio quando Rubin sarà sul mercato significa rischiare di inaugurare un impianto già pensato per una generazione in fase di superamento. Per i grandi acquirenti di capacità di calcolo, questo non è un dettaglio trascurabile.
Aggiungere megawatt non basta: bisogna che arrivino sincronizzati con la finestra giusta del silicio
È una dinamica strutturale dell'AI industriale: il ciclo di aggiornamento delle GPU — circa un anno — è molto più rapido dei tempi necessari per costruire e allacciare un data center di questa scala, che si misurano in anni. Chi investe in infrastruttura deve anticipare non dove è il mercato oggi, ma dove sarà quando i cantieri saranno terminati.
L'energia è il vero collo di bottiglia
Dietro ogni annuncio di campus da gigawatt c'è un problema che raramente finisce sui titoli: trovare abbastanza elettricità, nel posto giusto, al momento giusto. Nel materiale tecnico legato al progetto di Abilene compaiono indicazioni su sottostazioni a 345 kV e fasi di espansione da centinaia di megawatt — numeri che escono completamente dalla logica del real estate tradizionale e si avvicinano a quella delle grandi infrastrutture nazionali.
In Texas, dove il settore dei data center gode di un ecosistema normativo favorevole, la domanda di energia cresce comunque più velocemente della capacità di consegnare nuove connessioni e linee di trasmissione in aree specifiche. Quando si aggiungono carichi da centinaia di megawatt che competono con la crescita industriale locale, i tempi si allungano e le certezze si riducono. Il disallineamento tra il momento in cui arriva l'hardware e quello in cui arriva l'energia utilizzabile è uno dei rischi operativi più sottovalutati di questa fase.
La risposta è distribuire, non concentrare
L'accordo più ampio tra Oracle e OpenAI rimane in piedi: 4,5 gigawatt di capacità Stargate aggiuntiva negli Stati Uniti, un impegno che non viene ridimensionato dalla vicenda texana. Quello che cambia è la geografia. La logica che emerge è quella di un mosaico di siti distribuiti, non di un unico mega-campus: oltre al Texas, sono stati annunciati piani in Wisconsin, nell'area di Port Washington fuori Milwaukee, con Vantage Data Centers tra i partner, e sono circolate indicazioni su ulteriori hub nel Midwest.
La logica è chiara: distribuire la capacità su più siti riduce il rischio di esecuzione, avvicina i data center alle fonti di energia disponibili e rende meno critico un singolo punto di fallimento. La capacità di calcolo è diventata in un certo senso portabile: non è essenziale che tutto sia concentrato nello stesso campus, a patto che i siti siano collegati da reti ad alte prestazioni e governati da contratti coerenti.
L'asset più scarso nell'AI industriale non è l'ambizione nei piani, ma la capacità di esecuzione sincronizzata
Oracle difende la narrativa, il mercato guarda i fatti
La risposta pubblica di Oracle alle ricostruzioni giornalistiche — con la distinzione tra il campus principale e l'espansione aggiuntiva definita "non parte del perimetro core" — va letta anche come gestione della reputazione. Oracle ha bisogno che la narrativa resti quella di un fornitore cloud capace di gestire i workload AI più avanzati, non di un operatore che fatica quando la complessità aumenta. Nel mercato, il segnale più osservato non è se un singolo ampliamento slitta, ma se OpenAI continua ad acquistare capacità e se quella capacità entra davvero in esercizio.
Da questo punto di vista, il fatto che gli edifici già in costruzione ad Abilene siano previsti in consegna entro metà 2026 è più rilevante della polemica sull'espansione bloccata: è quella quota di capacità che, se completata nei tempi, potrà essere assorbita subito da carichi di lavoro reali. E se player come Meta stessero valutando di occupare spazi eventualmente liberati da Crusoe, significherebbe che il problema non è trovare domanda, ma orchestrarla con le condizioni operative e contrattuali giuste.
Cosa guardare davvero nei grandi annunci
Per chiunque utilizzi o stia pianificando di utilizzare capacità di calcolo AI su larga scala — per addestrare modelli, per il fine-tuning (adattamento di modelli pre-esistenti a compiti specifici) o per l'inferenza in produzione — la vicenda di Abilene offre una lezione pratica. Le roadmap pubbliche dei campus vanno lette come programmi in evoluzione, non come certezze lineari. La domanda da farsi non è quanti megawatt vengono annunciati, ma quanti di quei megawatt hanno già un'allocazione di energia confermata, un sistema di raffreddamento validato e una data di disponibilità credibile.
L'AI industriale sta imponendo ai data center un ritmo da supply chain del settore semiconduttori, mentre l'energia resta vincolata ai tempi di una supply chain da infrastruttura nazionale. La partita dei 4,5 GW Oracle-OpenAI non si misurerà sull'annuncio, ma su quanti siti entreranno in esercizio con energia stabile e raffreddamento affidabile nel momento in cui il mercato sposterà l'asticella da Blackwell a Rubin.