Su eBay un cluster da 9.600 GPU Nvidia A100 per 59,7 milioni
L'inserzione di Core 4 Solutions è stata chiusa il 28 ottobre senza conferma di vendita e mostra il mercato dell'hardware AI usato
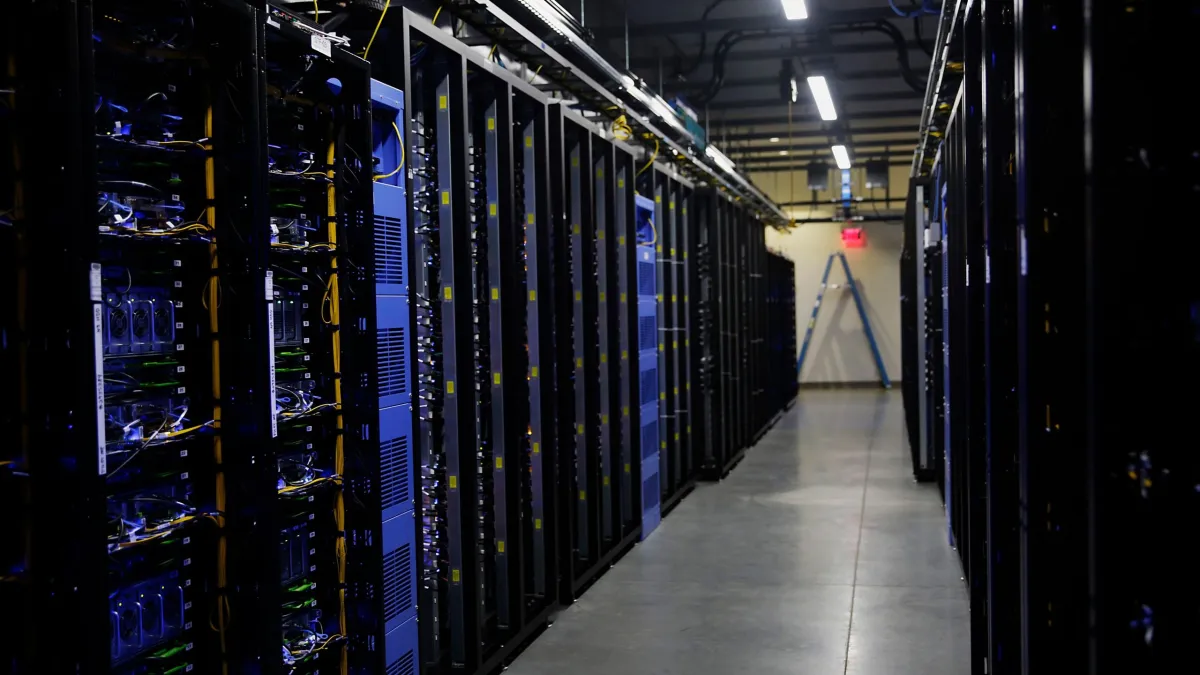
Che fine fanno i computer per l'intelligenza artificiale quando smettono di essere l'ultima novità? Una risposta arriva da un'inserzione comparsa su eBay: l'azienda Core 4 Solutions metteva in vendita un'infrastruttura da 300 rack, con 9.600 acceleratori Nvidia A100 e 4.200 processori AMD EPYC Rome, per 59,7 milioni di dollari. Un rack è l'armadio metallico che ospita i server nei centri dati. Gli acceleratori sono le schede grafiche (GPU) usate per addestrare ed eseguire i modelli di AI. L'offerta pone una questione concreta per imprese e ricerca: quanto vale una capacità di calcolo già costruita, quando bisogna trasportarla, alimentarla e adattarla a nuovi usi?
Un'inserzione chiusa il 28 ottobre
Conviene partire da una precisazione sul prezzo. Il prezzo era una richiesta negoziabile, con la formula o migliore offerta, e non la base di un'asta competitiva. Al 4 novembre 2026 l'inserzione risulta terminata: eBay indica la chiusura da parte del venditore il 28 ottobre, perché l'articolo era diventato indisponibile. Dalla pagina manca una conferma pubblica dell'acquisto, quindi l'esito commerciale resta ignoto.
La cifra di 59,7 milioni indica solo l'aspettativa del venditore
Cosa c'è dentro i 300 rack
Ogni rack contiene quattro nodi di calcolo, cioè server autonomi. Ciascun nodo ospita otto A100 da 40 GB di memoria nel formato SXM4, due processori EPYC Rome a 64 core e un terabyte di memoria DDR4-2933. A ogni rack si aggiungono tre server di gestione, anch'essi con due processori. Nel complesso la memoria di sistema supera il petabyte, cioè oltre mille terabyte. Questa memoria è diversa da quella montata sugli acceleratori, che serve a tenere modelli e dati durante l'elaborazione.
SXM4 è il formato di moduli progettati per schede server specifiche, con alimentazione, dissipazione del calore e collegamenti dedicati. Il valore del lotto sta anche in questa integrazione già realizzata. Le GPU di un nodo comunicano tra loro tramite NVSwitch, un commutatore interno ad alta velocità, mentre le interfacce ConnectX-6 collegano il nodo alla rete esterna. Per trasformare il tutto in un cluster efficiente servono però una rete progettata con cura, collegamenti verificati e un sistema di archiviazione che fornisca i dati al calcolo abbastanza in fretta.
Un chip anziano ma ancora utile
L'A100, presentata nel 2020, ha ancora impieghi validi. L'A100 conserva caratteristiche utili per addestrare reti di visione, analizzare dati, eseguire simulazioni scientifiche e fare inferenza, cioè far girare modelli già addestrati. Il supporto al calcolo in doppia precisione, un formato numerico molto accurato, interessa le applicazioni scientifiche, che hanno requisiti diversi da quelli dei chatbot. La funzione Multi-Instance GPU permette poi di dividere un acceleratore in più ambienti isolati, comoda per laboratori che devono distribuire risorse tra progetti piccoli.
Il limite più immediato dell'età del chip è la memoria. Un modello più grande dello spazio disponibile su una singola GPU va suddiviso tra più schede, compresso nei suoi parametri oppure appoggiato alla memoria del server. Sono soluzioni praticabili, ma incidono su prestazioni, complessità e a volte sulla qualità del risultato. Per un servizio aziendale che consulta documenti, per esempio, contano la dimensione del modello, la lunghezza dei testi e il numero di richieste simultanee: il numero di acceleratori offre solo una parte della risposta.
Il confronto con Blackwell e Rubin
Blackwell e Vera Rubin spostano il confronto verso memoria, comunicazione e rendimento energetico dell'intera piattaforma. Sono le generazioni più recenti di Nvidia: incorporano funzioni dedicate ai modelli transformer, l'architettura alla base dei sistemi di AI generativa, e formati numerici più compatti. Rubin estende l'integrazione tra processori, acceleratori e rete. Applicare alle A100 un coefficiente di svantaggio valido per tutti i casi sarebbe però fuorviante, perché il divario cambia con il programma eseguito. Anche le promesse sul costo per token, le unità di testo elaborate dai modelli, richiedono carichi e condizioni di confronto dichiarati.
Test che valgono per un solo nodo
Dai test commerciali pubblicati per questi rack emerge che l'ottimizzazione del software aumenta sensibilmente la velocità di generazione, con una lieve variazione dell'accuratezza misurata. Sono risultati del venditore e riguardano un singolo nodo. Resta da dimostrare che valgano per l'intera infrastruttura. Molte richieste indipendenti si distribuiscono facilmente tra i server, mentre un unico addestramento distribuito richiede sincronizzazioni frequenti, il cui costo dipende dalla rete. Chi volesse comprare dovrebbe dunque orientare il collaudo proprio su questo punto, prima della trattativa.
Rack singoli per chi compra meno
La presenza su eBay dà visibilità a un'offerta rivolta comunque a professionisti. Le ragioni della dismissione restano ignote: l'inserzione mostra un tentativo di ricollocamento e nulla di più sulle decisioni del precedente proprietario. Sul catalogo diretto compaiono anche rack singoli, proposti a circa 200.000 dollari. Questa formula modulare potrebbe interessare più del blocco completo a università, fornitori di servizi e aziende con infrastrutture proprie, che avrebbero una prima valutazione su scala gestibile.
L'energia e la rete decidono la convenienza di un impianto di calcolo usato
Il conto dell'energia
Il costo di esercizio restringe ancora la platea. Moltiplicando la potenza termica nominale massima degli acceleratori, circa 400 watt ciascuno, per il loro numero si ottengono circa 3,84 megawatt per le sole GPU: l'equivalente, come ordine di grandezza, di oltre mille abitazioni con contratto da 3 chilowatt. È una stima di progetto, diversa dall'assorbimento misurato con un'applicazione reale, e va sommata a quella di processori, rete, alimentatori e raffreddamento. La convenienza andrebbe calcolata sul lavoro effettivamente completato, includendo energia, manutenzione e utilizzo medio. Un impianto usato di rado può costare più di una capacità cloud acquistata solo quando serve.
Trasporto, norme e controlli
Un compratore italiano dovrebbe includere nel preventivo trasporto internazionale, assicurazione, movimentazione e installazione, oltre alla compatibilità elettrica del sito. Il venditore dichiara controlli sull'utilizzatore finale per gli ordini dall'estero: che un prodotto sia visibile online non significa che sia spedibile. Nel quadro europeo sono inoltre previsti obblighi di rendicontazione energetica per i data center sopra una determinata soglia. Il riuso dell'hardware va quindi valutato insieme all'efficienza dell'impianto che lo ospita, alla capacità elettrica disponibile e alle procedure applicabili.
Cosa verificare prima della consegna
Per i rack del catalogo diretto sono dichiarati test sotto carico e sostituzione anticipata in garanzia. Queste condizioni andrebbero scritte espressamente nel contratto del lotto acquistato. La gestione avviene a distanza tramite interfacce a riga di comando e console seriale, con procedure di installazione ancora da predisporre. Prima di accettare la consegna restano da concordare inventario, ricambi, prove sulla memoria degli acceleratori e misure di prestazioni tra i nodi, cioè proprio la parte del sistema per cui mancano risultati pubblicati su larga scala.