OpenAI e Broadcom presentano Jalapeño, il chip pensato per far girare l'AI
Il primo processore custom di OpenAI è ottimizzato per l'inferenza, la fase in cui i modelli rispondono agli utenti ogni giorno: una scelta che va ben oltre l'hardware
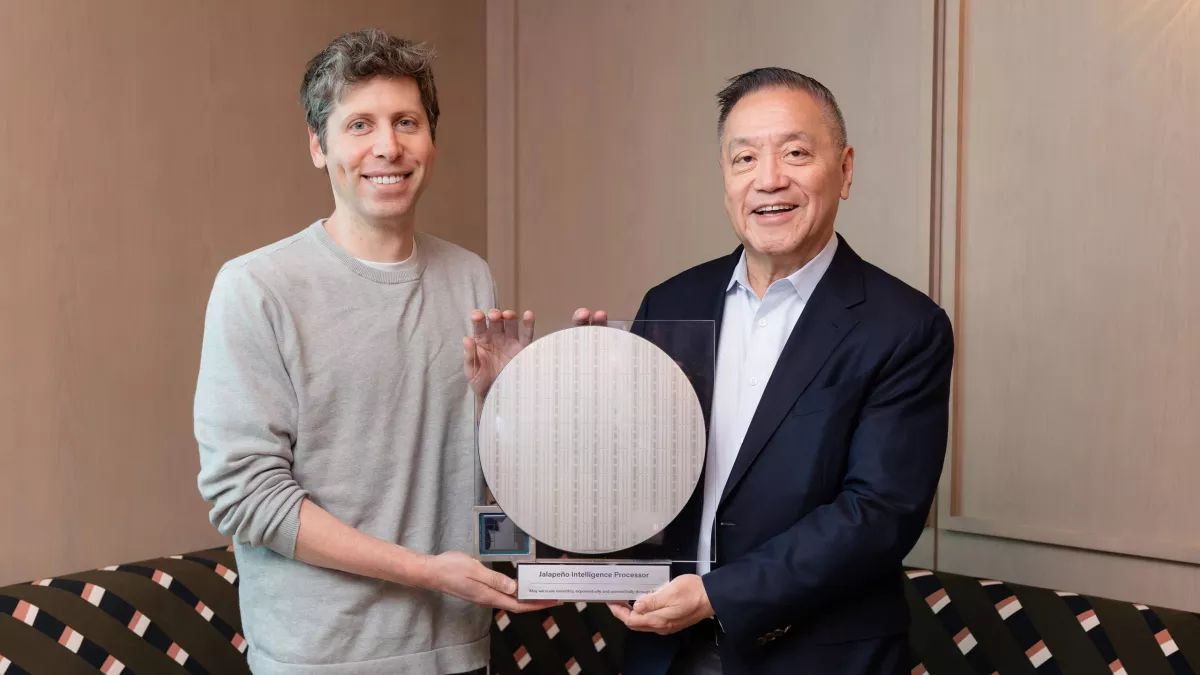
Ogni volta che ChatGPT risponde a una domanda, ogni volta che un assistente AI completa un testo o suggerisce del codice, avviene qualcosa che nel gergo tecnico si chiama inferenza: il modello, già addestrato, elabora la richiesta e genera una risposta. È un processo che accade miliardi di volte al giorno, e il cui costo — in energia, in tempo, in hardware — è uno dei problemi più concreti che le grandi aziende di AI devono affrontare. È in questo contesto che va letto l'annuncio di Jalapeño, il primo chip progettato direttamente da OpenAI insieme a Broadcom, presentato il 24 giugno 2026.
Un chip costruito per rispondere, non per imparare
Nel mondo dell'intelligenza artificiale esiste una distinzione fondamentale tra due fasi: il training, in cui un modello viene addestrato su enormi quantità di dati — un processo lungo, costoso, che avviene relativamente di rado — e l'inferenza, che è invece la routine quotidiana: ogni risposta generata, ogni richiesta elaborata via API. Jalapeño è stato progettato esclusivamente per l'inferenza, non per il training. Questo lo rende diverso dalla maggior parte degli acceleratori oggi sul mercato, che nascono come strumenti polivalenti e vengono adattati all'AI.
Il chip appartiene alla categoria degli ASIC, ovvero circuiti integrati costruiti per uno scopo preciso, al contrario delle GPU — le schede grafiche riadattate al calcolo AI — che sono progettate per essere flessibili e generiche. Un ASIC dedicato all'inferenza può essere più efficiente perché incorpora direttamente nel silicio le operazioni che servono davvero, eliminando tutto il resto. Il compromesso è la specializzazione: quello che guadagni in efficienza, lo perdi in versatilità.
L'inferenza è la fase in cui si accumulano i costi reali dell'AI, non il training
Il comunicato congiunto del 24 giugno 2026 colloca Jalapeño come primo acceleratore di una piattaforma pensata per evolvere su più generazioni, con l'obiettivo dichiarato di rendere l'AI «più veloce, più affidabile e più accessibile». L'ambizione è esplicita: costruire data center su scala gigantesca — nell'ordine del gigawatt di potenza installata — insieme a Microsoft e altri partner, a partire dal 2026. Non si tratta di un singolo chip, ma di una scommessa infrastrutturale complessiva: catena di fornitura, packaging avanzato, raffreddamento, gestione del carico di lavoro.
Perché l'AI agentica cambia le regole
OpenAI insiste su un punto specifico: Jalapeño non è una versione adattata di un acceleratore da training, ma un'architettura costruita attorno a ciò che nell'inferenza moderna fa davvero la differenza. Non solo la potenza di calcolo, ma la velocità con cui i dati si muovono nella memoria, la gestione della rete interna e la capacità di servire molte richieste contemporaneamente senza perdere in reattività.
Questo diventa particolarmente critico con la cosiddetta AI agentica: sistemi in cui un modello non si limita a rispondere, ma pianifica, usa strumenti, verifica risultati, fa più passaggi in sequenza. Rispetto a una semplice domanda-risposta, un agente AI genera molte più operazioni intermedie, con tempi variabili e dipendenze difficili da prevedere. In questo scenario, la qualità dell'hardware si misura sulla capacità di mantenere bassa la latenza anche quando il carico è irregolare — non sulla potenza di picco.
Tanti annunci, pochi numeri
I dettagli tecnici resi pubblici sono volutamente scarsi. Si parla di un ampio compute chiplet — un blocco di calcolo modulare — e di memoria HBM, con un design orientato ad alto throughput e bassa latenza. Ma non ci sono cifre pubbliche su consumi energetici, banda di memoria, precisioni di calcolo supportate o benchmark comparabili con altri chip. In un mercato dove la credibilità si misura su metriche ripetibili — dalla latenza al costo per milione di token elaborati — l'assenza di dati concreti è una scelta comunicativa che lascia aperte molte domande.
Un confronto utile arriva da Microsoft, che a gennaio 2026 ha presentato Maia 200, il proprio acceleratore per l'inferenza, con numeri precisi: 216 GB di memoria HBM3e, una banda di 7 TB al secondo, 272 MB di memoria SRAM on-chip, e un miglioramento dichiarato del 30% nelle prestazioni per dollaro rispetto all'hardware precedente. Quel livello di dettaglio crea un punto di riferimento: chi acquista capacità computazionale ha bisogno di numeri confrontabili per decidere, e Jalapeño dovrà prima o poi parlare lo stesso linguaggio.
Broadcom, il partner che conta
La scelta di Broadcom come partner non è casuale. Negli ultimi anni l'azienda si è affermata come uno dei principali abilitatori del custom silicon per i grandi operatori cloud — i cosiddetti hyperscaler — con una doppia competenza rara: sa progettare e industrializzare acceleratori su misura, e ha una posizione molto forte nel networking per cluster AI, cioè nella rete interna che collega migliaia di chip tra loro.
I numeri di Broadcom rendono concreto ciò che altrimenti sembrerebbe sperimentale. Nel trimestre chiuso il 1° febbraio 2026, l'azienda ha dichiarato 8,4 miliardi di dollari di ricavi legati all'AI, con una crescita del 106% rispetto all'anno precedente, trainati proprio da acceleratori custom e networking per AI. Significa che la domanda di chip non-GPU è già industriale, e che Broadcom ha la massa critica per sostenere programmi di sviluppo su più generazioni.
La domanda di chip personalizzati per l'AI è già su scala industriale, non sperimentale
Il vantaggio degli ASIC e i suoi limiti
In linea di principio, un ASIC può essere più efficiente di una GPU per un compito specifico: fissare in silicio un insieme di operazioni frequenti permette di eliminare strati di circuiteria generica che consumano energia e spazio. Ma questo vantaggio non è automaticamente difendibile nel tempo.
Le GPU di ultima generazione migliorano rapidamente, e soprattutto sono accompagnate da un ecosistema software maturo: compilatori, librerie ottimizzate, strumenti di analisi delle prestazioni, framework per il deployment. Un ASIC deve colmare questo gap con una co-progettazione molto stretta tra hardware e software — altrimenti rischia di eccellere in laboratorio e deludere nel mondo reale. È per questo che OpenAI sottolinea che Jalapeño è stato progettato a partire dai sistemi che l'azienda fa girare ogni giorno su ChatGPT, sulle proprie API e su Codex, il suo strumento per la generazione di codice.
L'annuncio precisa anche che il chip è pensato per modelli «attuali e futuri dell'industria», non solo per quelli proprietari di OpenAI. Se questa apertura si tradurrà in accesso reale per sviluppatori terzi — tramite istanze cloud, routing automatico dei carichi o altro — Jalapeño potrebbe cambiare i costi per chi oggi paga la cosiddetta «Nvidia tax»: il sovrapprezzo implicito che deriva dalla dipendenza quasi totale dall'ecosistema Nvidia per il calcolo AI.
Il nodo della produzione su larga scala
Un acceleratore moderno per modelli linguistici di grandi dimensioni non è solo un chip: è un sistema complesso che include packaging avanzato in formato 2.5D, memorie HBM che competono su disponibilità con tutte le altre iniziative AI del settore, e una catena produttiva che negli ultimi anni ha mostrato colli di bottiglia difficili da aggirare.
Alcune analisi di mercato indicano che la capacità CoWoS di TSMC — la tecnologia di packaging avanzato più usata per i chip AI — è in espansione e nel 2026 potrebbe raggiungere un range stimato di 120.000–140.000 wafer al mese. È un segnale positivo, ma non elimina la competizione tra clienti: quando una risorsa produttiva è scarsa, chi riesce a prenotare capacità in anticipo e garantire volumi ha un vantaggio decisivo. L'execution industriale, non la progettazione, sarà il vero banco di prova per Jalapeño.
Il quadro europeo sullo sfondo
C'è infine una dimensione geopolitica che vale la pena tenere presente, soprattutto guardando dall'Europa. Jalapeño arriva in un momento in cui l'Unione Europea sta rafforzando le proprie politiche industriali sui semiconduttori. La Commissione europea indica che il Chips Act ha già generato numerose decisioni su aiuti di Stato per impianti innovativi, e a giugno 2026 ha proposto un «Chips Act 2.0» con nuove misure per ridurre le dipendenze strategiche.
Sul fronte italiano, l'attenzione si concentra soprattutto su packaging, assemblaggio e testing — fasi che diventano sempre più decisive proprio mentre l'AI si sposta verso architetture a chiplet e memorie HBM. A marzo 2026 la Commissione ha riconosciuto lo status di Open EU Foundry a una struttura per chiplet a Novara, segnale che il packaging non è più considerato una fase secondaria rispetto alla fabbricazione vera e propria.
Jalapeño mette pressione su più fronti contemporaneamente: su Nvidia, perché rende esplicito che alcuni dei suoi maggiori clienti vogliono alternative concrete; su Microsoft, perché apre la questione di come orchestrare il proprio acceleratore Maia 200 insieme a un chip co-progettato con OpenAI senza frammentare l'infrastruttura; e su OpenAI stessa, perché la promessa di prestazioni superiori per watt consumato, senza benchmark pubblici, crea un'attesa che dovrà essere colmata con dati reali e disponibilità effettiva. Se l'inferenza è davvero il collo di bottiglia economico dell'AI, la misura del successo non sarà un grafico di throughput, ma la capacità di trasformare un chip in una piattaforma che regge la domanda quando quella domanda diventa abitudine quotidiana.